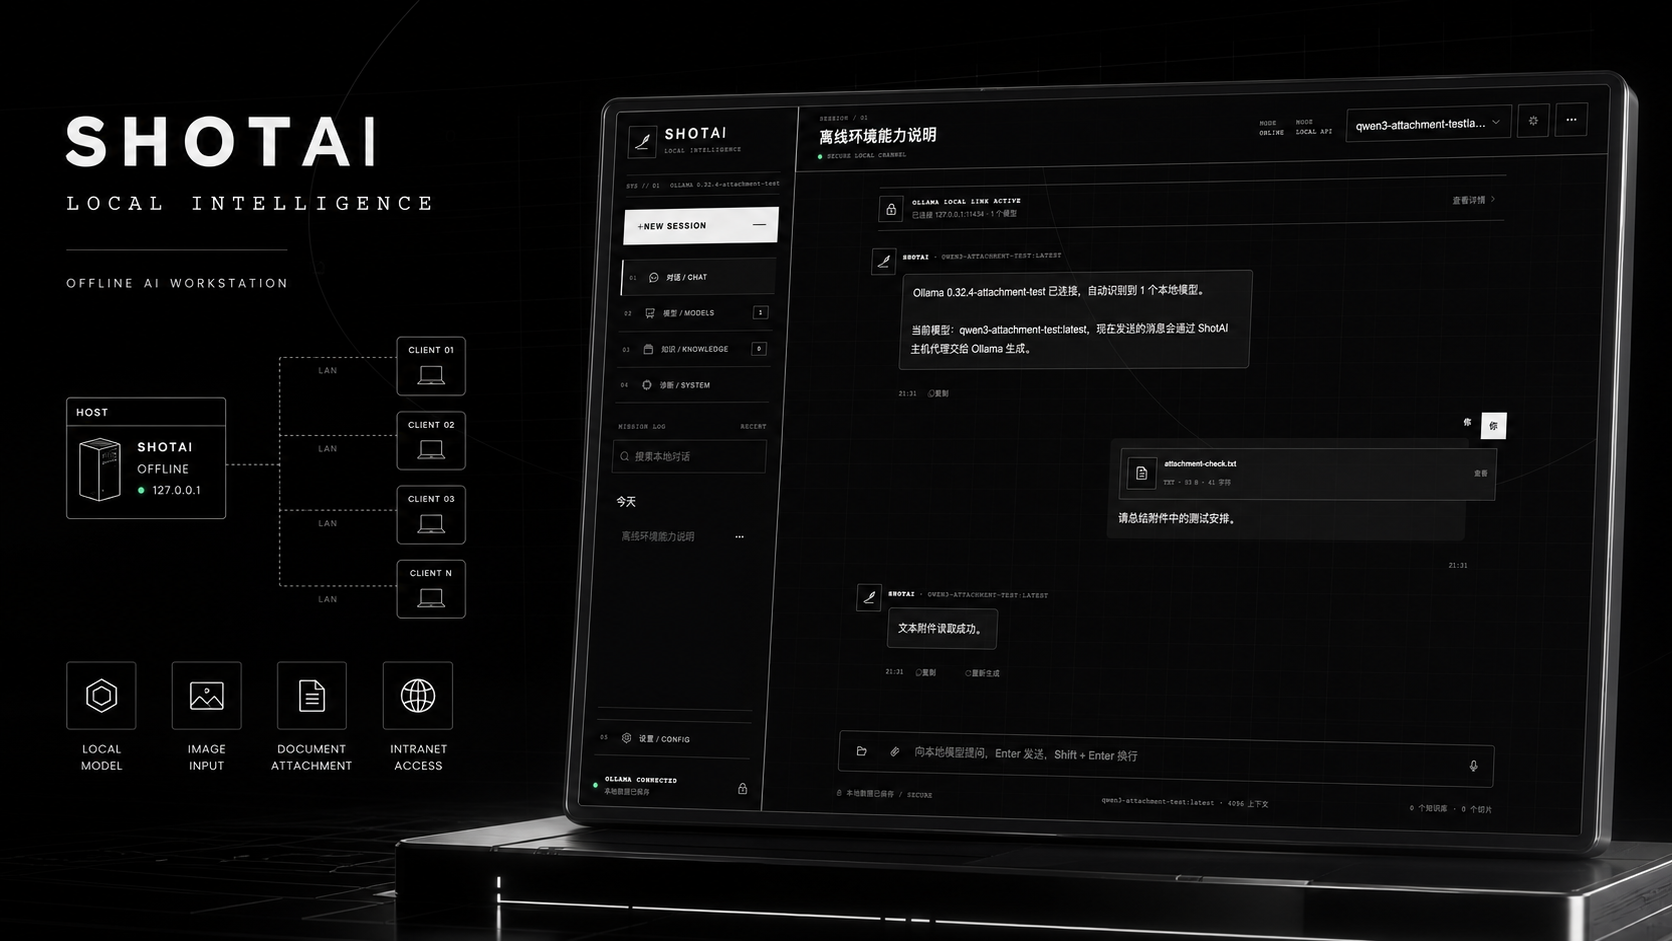
ShotAI 项目的一些杂谈:在断网的孤岛中,我们仍能对话
ShotAI,让你在与世界暂时失联的离线环境里,依然拥有思考、创作与对话的自由——因为真正重要的灵感,从来不该依赖一根网线,只是偶尔会依赖一块还没过热的显卡。
不管在哪里,在断网的孤岛中,我们仍能对话。
OK,上面是我扯淡的。主要的开发原因是:本人的工作环境处于离线断网状态,干什么事情都很费劲。得益于现在科技的发展和祖国的强大,让我有机会去实现一个可以在内网环境下离线部署的 AI。
GitHub 地址:
https://github.com/ReDChicagOTypewriteR/ShotAI
一、项目简介
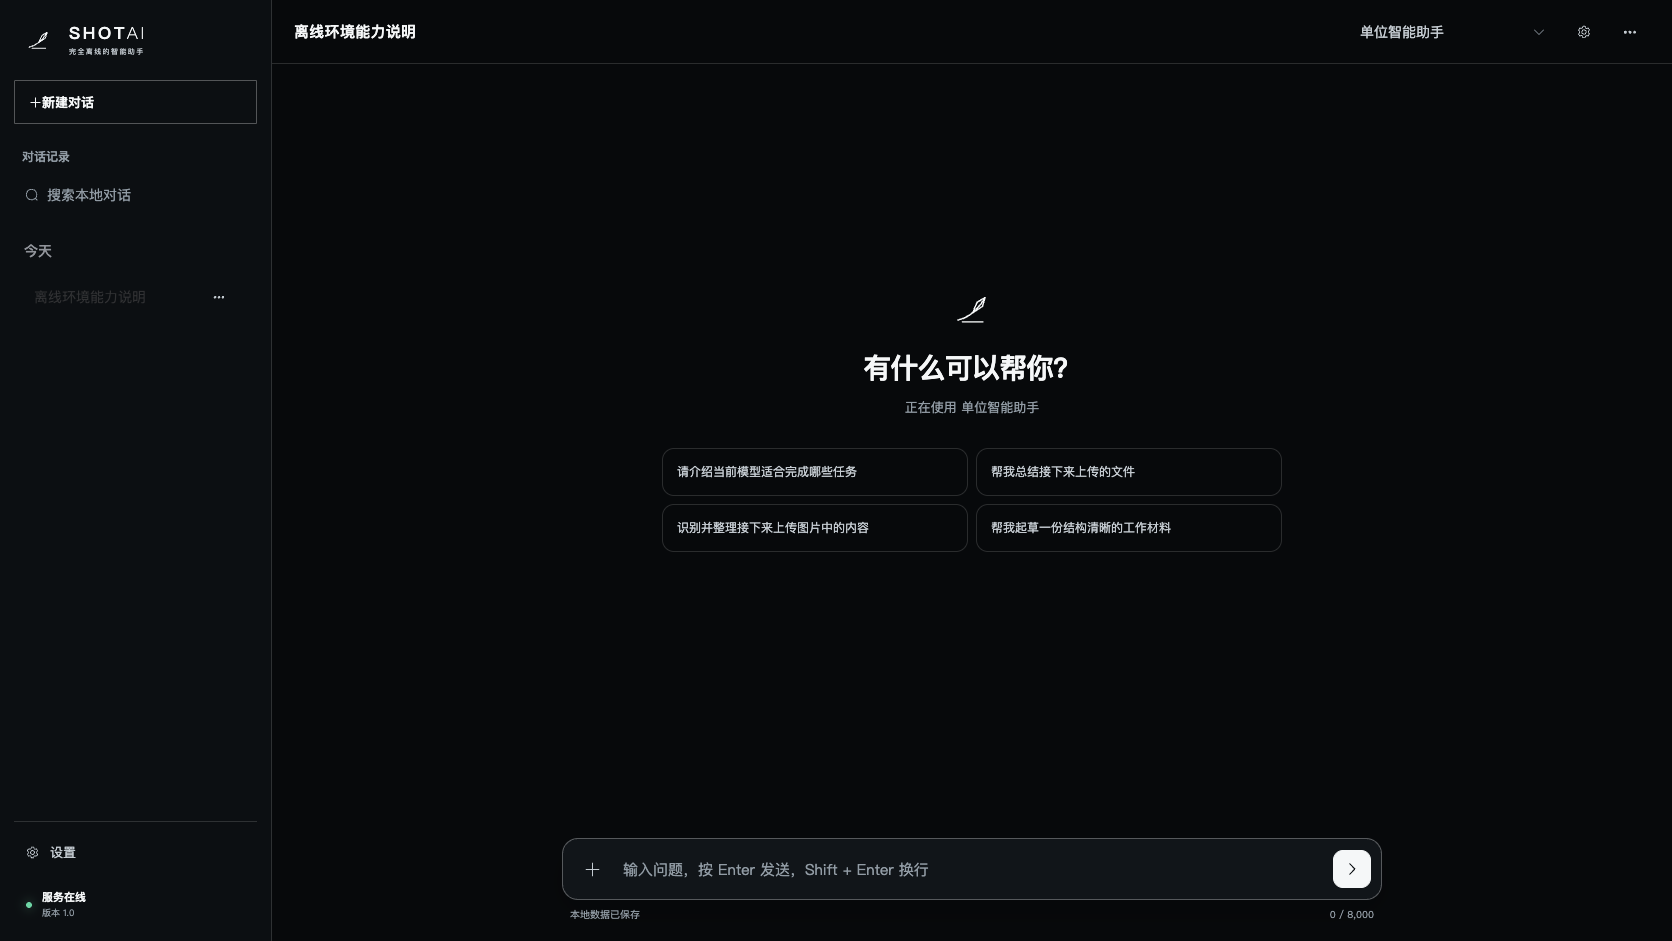
本项目是一套面向 Windows x64 和 Ubuntu 环境的本地与局域网 AI 工作台。项目将本地大模型对话、文件阅读、资料库检索、图片理解、图片生成与修改、模型管理等能力整合到统一的桌面应用中。
管理员只需在一台 Windows 主机或 Ubuntu 主机上安装 ShotAI 并导入模型,局域网内其他电脑即可通过浏览器访问主机的 9090 端口,无需分别安装 ShotAI、Ollama、Node.js、CUDA 或模型文件。所有模型推理和文件处理均在本地主机完成。
项目的主要能力包括:
- 本地流式对话、多会话管理、停止回答、重新生成和编辑问题;
- PDF、Word、Excel、CSV、TXT、Markdown 等文件读取;
- 本地资料库建立、检索及引用;
- 图片识别、截图分析和文档页面理解;
- 在普通对话中自动识别图片生成要求;
- 根据上一张图片继续执行颜色、背景、风格和细节修改;
- 聊天、图片识别、资料检索和图片生成模型统一管理;
- 模型导入、校验、复用、删除和缓存清理;
- 主机安装后为局域网提供统一访问入口。
ShotAI 不在安装包中提供模型权重。用户安装完成后,可以根据电脑配置自行导入兼容模型。
目前项目分别实现了 Windows 和 Ubuntu 两个平台版本。两者使用同一套公共核心,界面、会话、文件、资料库、模型抽象和基础交互基本一致;不同之处主要集中在安装方式、系统路径、进程管理、GPU 运行环境、并发能力和监控方式。
| 平台 | 主要定位 | 安装与运行方式 |
|---|---|---|
| Windows x64 | 个人主机、办公室工作站和小规模局域网使用 | Electron 桌面程序、NSIS 安装器、内置 Windows Ollama 与 CUDA 12 运行组件 |
| Ubuntu 22.04 x86_64 | GPU 服务器、较高负载和多人局域网使用 | DEB / AppImage、内置 Linux Ollama 与 CUDA 12 运行组件,并提供并发和主机监控能力 |
二、技术架构
2.1 总体架构
ShotAI 采用“公共核心 + 平台适配层 + 本地推理运行时”的分层架构。
前端负责统一交互,本地服务负责局域网访问、任务路由和模型管理,底层由 Ollama 与 stable-diffusion.cpp / sd-server 执行推理。Windows 和 Ubuntu 共用上层功能,只在与操作系统、硬件和发布方式有关的部分分别实现。
flowchart TB |
2.2 公共核心
公共核心负责与操作系统无关的功能,主要包括:
- Vue 聊天界面;
- 流式回答、思考内容展示和参数设置;
- 会话创建、编辑、删除、重新生成和本地持久化;
- PDF、Word、Excel、文本等资料解析与资料库检索;
- 聊天、图片识别、资料检索和图片生成等统一模型接口;
- 模型列表、运行状态和能力识别;
- 对话任务路由;
- 图片生成和修改意图识别;
- 本地数据存储;
- 通用功能测试和交互测试。
公共核心不直接处理 Windows 注册表、Ubuntu 路径、CUDA 动态库、安装器或系统进程,而是通过统一的服务接口调用平台层。
2.3 本地服务与推理层
ShotAI 的桌面界面和局域网浏览器都通过 9090 端口访问同一套本地服务。Vue 前端不直接连接 Ollama 或图片运行组件,而是由 ShotAI 统一接收和转发请求。
当前推理层包含两套相互独立的运行组件:
- **文本与图片理解:**使用内置 Ollama,支持 GGUF 模型、流式回答、资料检索和 CUDA 推理;
- **图片生成与修改:**使用
stable-diffusion.cpp的sd-server,支持单文件模型和多组件图片模型。
整体调用关系可以概括为:
Windows / Ubuntu 桌面程序或局域网浏览器 |
2.4 Windows 平台层
Windows 平台层负责:
- Electron 桌面窗口和系统托盘;
- Windows NSIS 安装程序;
- 内置 Ollama 与 CUDA 12 运行组件;
- 图片生成运行组件;
- Windows 路径和用户数据目录;
- 后台进程启动、停止和异常恢复;
- 端口检测和旧版本进程提示;
- Windows 防火墙和局域网访问;
release/windows安装包输出。
Windows 版更偏向个人电脑和办公室工作站使用。Electron 主程序负责启动网页服务、内置 Ollama 和图片运行组件,并在关闭窗口后通过系统托盘继续提供服务。
2.5 Ubuntu 平台层
Ubuntu 平台层面向 Ubuntu 22.04 x86_64,主要负责:
- DEB 和 AppImage 安装包构建;
- Electron 主进程、系统托盘和程序生命周期管理;
- 内置 Ollama、CUDA 12 和图片运行组件启动;
- 独立端口、模型目录和运行环境隔离;
- 局域网服务器和五用户并发控制;
- CPU、内存、磁盘、GPU、显存和连接设备监控;
- 模型导入、缓存清理、失败日志和运行日志;
- Linux 路径、进程组、动态库和退出清理;
release/ubuntu安装包输出。
当前 Ubuntu 桌面版仍由 Electron 主进程托管各项服务,尚未切换为独立的 systemd 常驻服务。systemd 更适合作为后续纯服务器部署方式。
当前也没有接入 vLLM。Ollama 负责离线桌面使用和小规模并发,vLLM 可以作为后续更高并发服务器版本的可选后端。
2.6 两个平台的实现差异
| 对比项 | Windows x64 | Ubuntu 22.04 x86_64 |
|---|---|---|
| 公共界面 | Vue 3 工作台 | Vue 3 工作台 |
| 桌面容器 | Electron | Electron |
| 文本推理 | 内置 Windows Ollama | 内置 Linux Ollama |
| 图片推理 | stable-diffusion.cpp / sd-server |
stable-diffusion.cpp / sd-server |
| 安装方式 | NSIS 安装程序 | DEB / AppImage |
| 数据目录 | Windows 用户数据目录 | Linux 用户数据目录及安装包日志目录 |
| GPU 适配 | CUDA 12,主要面向 RTX 工作站 | CUDA 12,并针对 Tesla V100 的 sm_70 环境适配 |
| 并发能力 | 以个人和小规模局域网使用为主 | 最多接收 5 个活动推理请求、同时运行 2 个 |
| 主机监控 | 基础运行状态 | CPU、内存、磁盘、GPU、显存、队列和连接设备监控 |
| 发布目录 | release/windows |
release/ubuntu |
2.7 技术栈
| 层级 | 使用技术 |
|---|---|
| 前端界面 | Vue 3、TypeScript |
| UI 组件 | Element Plus、Vue Element Plus X |
| 构建工具 | Vite |
| 桌面客户端 | Electron |
| Windows 安装器 | Electron Builder、NSIS |
| Ubuntu 安装器 | Electron Builder、DEB、AppImage |
| 对话与图片理解 | Ollama、GGUF 模型 |
| 图片生成与修改 | stable-diffusion.cpp、sd-server |
| PDF 读取 | PDF.js |
| Word 读取 | Mammoth |
| Excel 与 CSV | SheetJS |
| Markdown 显示 | Marked、DOMPurify |
| 本地数据 | IndexedDB |
| 文件校验 | SHA-256、hash-wasm |
| 自动化测试 | Playwright、Node.js 测试脚本 |
三、技术实现
3.1 桌面应用与启动流程
ShotAI 使用 Electron 封装 Vue 工作台。Windows 和 Ubuntu 都通过桌面主程序管理本地服务和推理组件,基本启动流程包括:
- 检查是否已经存在 ShotAI 实例;
- 创建数据、模型、运行时和日志目录;
- 检查
9090端口是否被旧版本占用; - 读取并合并局域网配置;
- 检测系统 Ollama,并启动 ShotAI 内置 Ollama;
- 为内置 Ollama 选择独立端口和模型目录;
- 检查图片模型文件,满足条件时启动图片服务;
- 启动监听
0.0.0.0:9090的局域网服务; - 创建桌面窗口和系统托盘;
- 桌面窗口通过
127.0.0.1:9090加载同一套网页界面。
关闭窗口不会直接终止后台服务,用户可以通过系统托盘完全退出 ShotAI。只有完全退出时,桌面主程序才会停止 Ollama、图片服务和网页服务。
3.2 内置 Ollama 与服务隔离
Windows 和 Ubuntu 完整安装包都使用 ShotAI 自己的 Ollama 运行组件,不直接复用系统中已经运行的 Ollama。
ShotAI 启动时会:
- 检查系统 Ollama 是否占用
127.0.0.1:11434; - 为内置 Ollama 从
11435—11454中选择独立端口; - 为内置 Ollama 设置独立的模型目录;
- 让所有聊天请求通过 ShotAI 的
/ollama/api代理访问。
这样,系统 Ollama 与 ShotAI Ollama 的模型、端口和进程互不混用,可以避免系统 Ollama 中的模型、模板、缓存或版本影响 ShotAI。
Windows 下的独立模型目录为:
C:\Users\用户名\AppData\Roaming\ShotAI\data\models\ollama |
Windows 完整安装包中的 Ollama 相关组件包括:
ollama.exe |
Ubuntu 完整离线包则包含:
- Electron 桌面运行环境;
- ShotAI 前端和本地服务器;
- Linux x86_64 版 Ollama;
- Ollama CUDA 12 推理库;
stable-diffusion.cpp的sd-server;- 图片运行所需的 NCCL 动态库;
- Ubuntu DEB / AppImage 配置和图标资源。
3.3 局域网服务
ShotAI 在主机上提供统一的 9090 服务:
主机访问:http://127.0.0.1:9090 |
局域网浏览器的请求先进入 ShotAI 服务,再转发给主机内部的 Ollama 或图片运行组件。该方式解决了浏览器跨域、Ollama 403、图片文件访问和底层端口暴露问题。
局域网客户端只负责显示界面和发送请求,模型计算全部发生在 Windows 或 Ubuntu 主机上。
3.4 模型导入与分析
模型管理采用统一入口。用户选择文件后,系统根据扩展名、文件名、数量、大小和配套关系判断模型用途。
支持的主要类型包括:
- 单文件聊天 GGUF;
- 多分片 GGUF;
- 图片识别主模型和
mmproj配套文件; - 资料检索模型;
- 图片生成主模型;
- 图片生成文字理解文件;
- VAE 或图片编码、解码文件。
聊天模型采用流式导入方式,文件写入和 SHA-256 计算在同一次读取中完成,避免先复制一次、再完整读取一次进行校验。
完整导入流程包括:
- 判断模型用途;
- 检查配套文件是否完整;
- 将 GGUF 写入临时
.uploading文件; - 写入过程中同步计算 SHA-256;
- 检查文件长度、GGUF 文件头和版本;
- 检查张量和说明信息;
- 根据 SHA-256 判断相同文件是否已经存在;
- 复用已有文件,避免重复占用磁盘;
- 内置 Ollama 模式下登记到独立 Blob 目录;
- 调用 Ollama 创建模型清单;
- 实际加载模型并发送测试指令;
- 读取聊天、图片识别、思考或资料检索能力;
- 成功后刷新实际模型列表。
对于相同文件,系统优先复用已有 Blob,减少重复复制和磁盘占用。图片模型与聊天模型位于同一文件系统时,还可以通过硬链接复用相同 GGUF 文件。
导入中断时会清理:
.uploading |
模型管理页面的数据以实际 Ollama /api/tags 和图片模型目录为准,避免只依赖浏览器缓存显示已经删除的模型。
模型导入失败时,ShotAI 会记录失败阶段、文件信息、Ollama 版本、显卡和显存状态,方便排查文件损坏、版本不兼容或内存不足等问题。
3.5 对话与上下文管理
对话功能通过 Ollama 的流式接口实现。系统会根据模型可用上下文自动控制历史消息、文件内容和输出长度,避免请求超出模型容量。
主要实现包括:
- 流式显示回答;
- 用户主动停止生成;
- 手动滚动时不强制拉回底部;
- 编辑问题后重新生成;
- 回答中断后继续生成;
- 自动判断模型是否支持思考输出;
- 图片上传后自动切换到可识别图片的模型;
- 资料库启用后自动检索相关内容;
- 模型切换不影响已有会话记录。
3.6 图片模型与对话式图片生成
图片服务支持两种模型结构:
- **单文件模型:**例如 SDXL、Stable Diffusion 等完整模型;
- **多组件模型:**由图片主模型、文字编码器和 VAE 组成。
以 FLUX.2 Klein 9B 为例,运行时会自动识别:
flux-2-klein-9b-Q4_0.gguf 图片主模型 |
只有三个组件全部存在时,图片服务才会启动。缺少组件时,已经导入的文件会被保留,界面会显示缺少的具体文件,而不会把整个导入操作判定为失败。
图片服务默认只监听 127.0.0.1,外部用户必须通过 ShotAI 的 /image 代理访问,不能直接连接底层运行组件。
图片功能统一放在聊天流程中,用户不需要先切换到单独的“图片生成”页面。例如可以直接输入:
帮我生成一张未来城市夜景。
按照刚才的风格再生成一张。
把上面的图片增加一点蓝色。
对刚才的图片进行二次优化。
系统会通过本地规则和会话上下文识别图片生成意图,自动选择已经准备好的图片模型,并在聊天记录中显示生成进度、当前状态和最终图片。
如果用户是在询问“如何生成图片”“介绍图片模型”等知识问题,系统会继续按照普通聊天处理,避免错误调用图片模型。
3.7 上下文图片修改
ShotAI 会记录当前会话中最近生成或上传的图片。当用户提出后续修改要求时,系统会自动:
- 判断当前指令是否属于图片修改;
- 查找当前对话中的上一张图片;
- 读取上一张图片的原始描述;
- 将原始描述和本次要求组合成新的修改指令;
- 使用上一张图片作为参考图;
- 根据“稍微”“一点”“完全重做”等词语调整修改强度;
- 调用本地图片修改模型;
- 将结果继续显示在同一个对话中。
轻微修改默认保留更多原图内容,大幅修改则提高变化程度。生成过程中可以随时停止任务。
3.8 文件与资料库
文件处理全部在本地完成:
- PDF 使用 PDF.js 提取文字;
- DOCX 使用 Mammoth 解析;
- Excel 和 CSV 使用 SheetJS 读取;
- TXT 和 Markdown 直接读取;
- 图片文件交给视觉模型分析。
资料导入后会被拆分为本地检索片段。用户提问时,系统先查找相关内容,再将命中的资料和问题一起发送给模型,并在回答中显示引用来源。
3.9 本地数据存储
ShotAI 使用 IndexedDB 保存:
- 会话记录;
- 当前模型和会话设置;
- 资料库数据;
- 图片生成历史;
- 用户界面状态。
模型文件保存在系统用户数据目录中,不存入浏览器数据库。更新或重新安装 ShotAI 时,模型和本地数据默认保留。
3.10 停止生成与资源释放
前端为聊天和图片任务分别创建 AbortController。用户执行以下操作时会触发取消:
- 点击停止生成;
- 删除当前会话;
- 切换到其他会话;
- 中断图片生成。
取消链路如下:
前端 AbortController |
服务端同时监听请求的 aborted 和响应的 close。这是因为 POST 请求体发送完毕后,浏览器停止生成通常表现为响应连接关闭,而不一定触发请求端的 aborted。
对于尚未开始的排队请求,取消后会直接从队列中删除,不再占用排队位置。
3.11 Windows 平台的具体实现
Windows 版由 Electron 主程序负责窗口、托盘、路径和进程管理。Windows 完整安装包包含 ShotAI、Ollama、CUDA 12 和图片运行组件,但不包含模型权重。
Windows x64 版本使用 Electron Builder 和 NSIS 打包,安装包输出到:
release/windows |
构建验证包括:
- Vue 和 TypeScript 编译;
- Electron 启动检查;
- Windows 运行组件完整性;
- Ollama 和模型工具检查;
- 图片运行组件检查;
- CUDA 12 文件检查;
- 模型权重排除检查;
- 通用聊天、模型导入和局域网功能测试。
3.12 Ubuntu 完全离线运行与 V100 适配
Ubuntu 版的内置 Ollama 启动时设置:
OLLAMA_NO_CLOUD=true |
因此模型推理、模型管理和会话数据都可以在无互联网环境中完成。
Ubuntu 完整版固定优先加载 Ollama 的 cuda_v12 运行库,以兼容 Tesla V100 的 Compute Capability 7.0。启动 Ollama 时设置:
OLLAMA_LLM_LIBRARY=cuda_v12 |
图片服务启动时,LD_LIBRARY_PATH 同时包含:
- 图片运行组件目录;
- 内置 Ollama 的 CUDA 12 动态库目录;
- 系统原有动态库路径。
图片运行组件按照 sm_70 构建,并随安装包提供 libnccl.so.2,用于解决完全离线环境中的动态库依赖问题。
系统不会仅根据“检测到显卡”判断 CUDA 已启用,而是结合以下信息判断实际运行方式:
- Ollama
/api/ps返回的size_vram; - Ollama 日志中的 GPU offload 层数;
- 当前加载的计算库名称;
nvidia-smi返回的显存、利用率和温度。
只有模型实际占用显存时,监控界面才显示为 GPU 推理;否则会明确显示 CPU 或未知状态。
3.13 Ubuntu 五用户并发控制
当前并发参数为:
{ |
具体含义是:
- 最多接纳 5 个聊天或生成请求;
- 同时运行 2 个推理请求;
- 其余最多 3 个请求进入内存 FIFO 队列;
- 第 6 个请求返回 HTTP 429,并提示稍后重试。
并发调度目前只作用于:
/ollama/api/chat |
请求完成后释放运行槽位,并自动启动队列中的下一个请求。
这里的“五用户”准确来说是“五个同时活动的推理请求”,还没有实现按账号、IP 或会话进行独立配额。
3.14 Ubuntu 主机监控与日志
Ubuntu 主机监控通过本地接口采集:
- CPU 使用率和核心数;
- 内存使用量;
- 磁盘容量和使用率;
- NVIDIA GPU 数量、型号和温度;
- GPU 利用率与总显存占用;
- 当前模型、上下文长度和显存占用;
- GPU 卸载层数与实际计算后端;
- 并发运行数、排队数和拒绝数;
- 当前连接设备及最近活动时间;
- 模型导入状态和传输进度。
监控数据每 4 秒刷新一次。
监控平台仅允许运行 ShotAI 的主机访问。登录接口使用 POST,请求成功后签发 HttpOnly、SameSite=Strict 会话 Cookie。连续登录失败会触发短时锁定,降低暴力尝试风险。
Ubuntu 版记录以下日志:
| 日志文件 | 记录内容 |
|---|---|
desktop.log |
Electron 启动、端口、运行组件和退出信息 |
ollama.log |
模型加载、CUDA、GPU offload 和推理错误 |
image-runtime.log |
图片服务启动和动态库加载错误 |
model-import.log |
模型导入阶段、文件信息、GPU 状态和失败原因 |
ShotAI-model-import.log |
放置在桌面,便于离线环境直接查看和传出分析 |
DEB 安装后会创建:
/var/log/shotai |
AppImage 优先在 AppImage 同级目录创建 ShotAI-logs。如果该位置不可写,则回退到桌面或用户数据目录。
日志中会区分:
- CUDA 动态库是否找到;
- Ollama 是否启动成功;
- 使用的是内置还是系统 Ollama;
- 是否实际占用 GPU 显存;
- 模型文件是否完整;
- GGUF 版本是否受支持;
- 图片模型组件是否齐全;
- 请求是失败、取消还是排队超限。
3.15 Ubuntu 打包与发布
Ubuntu 完整版使用 Electron Builder 生成:
- Ubuntu 22.04 x86_64 DEB;
- Ubuntu 22.04 x86_64 AppImage。
安装包输出到:
release/ubuntu |
四、一些关于项目的反思和后续
4.1 关于模型厂商的选取和导入
首先就是最重要的问题:厂商的统一和模型的导入。这个其实比较难,不管什么事情,最难的可能就是“统一”。
当前的导入识别方式有点蠢,是把“模型厂商、下载来源、文件格式、推理后端”混在了一起。例如 Qwen3.5:
- 模型厂商:阿里 Qwen;
- 下载来源:Hugging Face 或 Ollama 模型库;
- 文件格式:GGUF;
- 推理后端:Ollama。
而当前图片模型则是:
- 主模型:FLUX.2 Klein 9B;
- 文本编码器:Qwen3 8B;
- VAE:
full_encoder_small_decoder.safetensors; - 推理后端:
stable-diffusion.cpp / sd-server。
理论上来说,整个系统不应该简单地按照“Qwen、DeepSeek、FLUX”分别编写导入逻辑,后续应该形成统一的模型记录和能力描述,而不是把厂商、来源、格式和运行方式写死在一起。
4.2 关于配置的要求
以我自己的工作环境为例,目前分别使用一台 Windows 主机和一台 Ubuntu 主机。
Windows 主机配置
- 处理器:Intel Core i9-14900KF,3.20 GHz;
- 内存:64 GB(约 63.8 GB 可用);
- 显卡:NVIDIA GeForce RTX 4070 Ti;
- 系统类型:64 位 Windows,x64 处理器。
Ubuntu 主机配置
计算显卡:
- NVIDIA Tesla V100 SXM2 32 GB × 2;
- 单卡显存:32 GB;
- 总显存:64 GB。
CPU:
- 型号:Intel Xeon E5-2696 v4 @ 2.20 GHz;
- 插槽:1;
- 物理核心:22;
- 逻辑 CPU:44;
- 每核心线程:2;
- 最大频率:3.70 GHz;
- 最小频率:1.20 GHz;
- NUMA 节点:1。
内存:
- 总内存:125 GiB。
当前启动参数使用了 CPU offload,125 GiB 内存足够支撑,但速度会受到 CPU 与 GPU 之间数据传输的影响。
反正用起来没什么问题,不过实际能运行什么模型、速度如何,还是要根据自己的配置因人而异。
4.3 并发情况下的考虑
这个也是自己一开始犯蠢。由于最初实现的是 Windows 下的 Demo,所以没有想得这么深。但是我的 Windows 主机配置并不能支持多个用户同时高负载使用,一个用户如果执行复杂任务,电脑再开个 PR,基本上就死机了,所以后来才考虑把服务放到服务器上。
当时也考虑过更换架构,因为我自己并不确定 Ollama 是否适合并发使用,也考虑过 vLLM,但如果直接更换,整体架构的改动会比较大,实现起来也更麻烦。
这里我着重说一下 Ubuntu 版本。
可能也是我的测试服务器配置问题,两张 32 GB V100 并不天然等于一张 64 GB 显卡。模型如果被拆分到两张卡上,可以运行更大的模型,但也会同时占用两张 GPU,反而降低并发能力。
假设办公室有五个人同时使用:一条大模型请求占用两张 GPU,其他四个人全部排队,图片生成还会与聊天争抢显存。
所以当前的并发实现可以概括为四层。
请求限制
- 最多接收 5 条对话请求;
- 2 条同时发送给 Ollama;
- 另外 3 条进入先进先出队列;
- 第 6 条返回 HTTP 429,提示稍后重试。
前端取消
用户点击停止、删除或切换会话时:
关闭 ShotAI 请求 |
此前只监听请求中断,POST 数据发送完成后可能监听不到。现在同时监听响应连接关闭,因此用户关闭网页或会话后,上游任务也会被中止。
我的测试已经验证:
- 运行任务可以取消;
- 排队任务可以取消;
- 取消后槽位立即释放;
- 新请求不再被已经停止的任务阻塞。
后续的改进方向是:目前“5 人”实际代表 5 条对话请求,而不是 5 个账号;图片生成和 Embedding 还没有进入同一个并发队列;两张 V100 也还没有固定分配。
所以当前已经解决了“停止后后台仍运行”的问题,但还没有完成聊天、图片和双 GPU 的统一调度。这个部分可能还要根据实际使用环境做自适应调整。
五、总结
ShotAI 最初只是为了解决离线工作环境下使用 AI 不方便的问题,后来逐步增加了局域网访问、文件和资料库、图片理解、图片生成与修改、模型管理、并发控制和主机监控。
Windows 与 Ubuntu 两个平台使用同一套公共核心:用户看到的是相同的聊天工作台,访问的是同一个 9090 服务,模型也都通过统一接口管理。两者的区别主要留在平台层:Windows 更关注桌面安装和个人工作站体验,Ubuntu 更关注服务器硬件适配、多人排队、GPU 状态与日志诊断。
目前它还不是一个已经完成所有设想的最终产品,但至少已经从“给 Ollama 套一个界面”走到了能够管理模型、处理文件、理解和生成图片,并为整个局域网提供统一服务的本地 AI 工作台。
微信扫码打开,再通过右上角菜单分享。
交流与讨论
评论由 Valine / LeanCloud 提供,点击后连接第三方服务。